Vũ Khôi
Tác giả tại Wotech Electronics Blog
凌晨 3 点的故障:结合 Metrics、Logs 和 Traces 找到连接池耗尽问题
PagerDuty 在凌晨 3 点叫醒了值班团队:结账 API 的 P99 延迟从 180ms 飙升到 3.2 秒,0.4% 的请求返回 504 错误。本文复述 Lữ Minh Khương 分享的排查过程——基于 pouria 频道的视频《3AM Observability Crash Course (A True Story)》——遵循"Wolf Fencing"(围狼)思路:从 Metrics 到 Logs 再到分布式追踪(Distributed Tracing),最终找到根本原因:连接泄漏耗尽了 PostgreSQL 连接池。以下所有数字均来自这篇分享帖,该帖复现了一次故障排查过程。
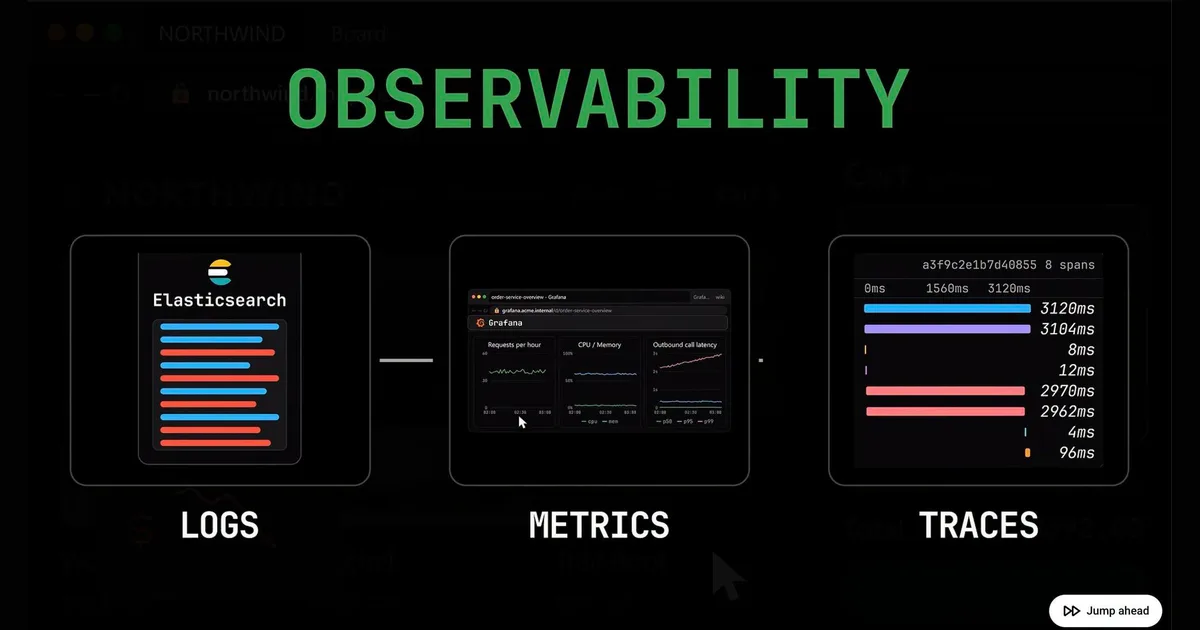
快速回答: 根本原因是连接泄漏(Connection Leak)耗尽了 Inventory Service 的连接池,而不是 CPU 过载或流量突增。Grafana 中的 Metrics 证明 Order Service 本身健康,只是在等待某个下游服务。Logs 把嫌疑范围缩小到对 Inventory Service 的调用。分布式追踪显示,从 PostgreSQL 获取连接花了 2,962ms,而 SQL 查询本身只花了 4ms。凌晨 3 点的临时处理办法是重启服务以重置连接池;彻底的修复办法是检查代码、确保每个连接都被关闭,并在 HikariCP 中开启泄漏检测。
可观测性(Observability) 是指通过系统产生的数据理解其内部状态的能力,通常通过三大支柱实现:Metrics(聚合指标)、Logs(事件日志)和 Traces(单个请求的完整旅程)。连接池耗尽(Connection Pool Exhaustion) 是指数据库连接池被全部占用,后续请求只能排队等待,直到超时。
凌晨 3 点发生了什么?
故事从一条严重的 PagerDuty 告警开始:API 网关层 POST /checkout 的 P99 延迟连续 5 分钟超过 2 秒。P99 是第 99 百分位数——99% 的请求都比这个值快,只有 1% 更慢。结账请求平时只需约 180ms,但在故障期间飙升到 3.2 秒,0.4% 的请求以 504 Gateway Timeout 失败。

按照作者的判断,做后端的人看到 API 网关返回 504 就知道,网关本身并没有坏——它只是在等待某个下游服务的响应等得太久。问题在于,系统中有数十个相互调用的微服务:浏览器经 CDN 到达 API 网关,网关转发到 Order Service,Order Service 再调用 auth、catalog、inventory 和 payment(经 Stripe),后端是 Redis 和 PostgreSQL。没有一套缩小范围的方法,值班人员会在数十个服务和海量数据中迷失。

什么是"Wolf Fencing"思维?为什么它有效?
视频回顾了一种经典的调试思维,叫"Wolf Fencing"(围狼)。要在幅员辽阔的阿拉斯加找到一匹狼,人们先筑一道篱笆把整个州一分为二,听狼嚎判断它在哪一半,然后继续把那一半一分为二,直到抓住它。处理生产故障也是如此:用可观测性工具一次筑起一道篱笆,逐步缩小搜索范围,而不是逐个服务去猜。

作者强调的关键点是筑篱笆的顺序:先从最便宜的全局视角(Metrics)开始,再深入到单个请求(Logs),只有当范围足够小的时候,才使用最昂贵、最详细的工具(Traces)。顺序颠倒——在还不知道哪个服务有问题时就直接钻进单个请求的追踪——会在系统着火的时候浪费大量时间。
Metrics 能告诉我们什么——又不能告诉我们什么?
第一道篱笆是检查 Grafana 中的 Metrics,数据每 15 秒从各服务的 HTTP 端点采集一次,存入 Prometheus 的时序数据库。打开 Order Service 的仪表盘后,作者查看三种基本指标来排除原因。
首先是 http_requests_total,属于 Counter(计数器)类型——数值只会随时间递增。其增长率图表显示流入流量保持平稳,约每小时 40 个请求,说明系统既没有遭受 DDoS 攻击,也没有流量突增。
其次是 CPU 和内存图表,属于 Gauge(仪表)类型——数值可升可降。Order Service 的 CPU 当时只有约 4%,内存持平,证明该服务本身非常空闲,既没有资源过载,也没有卡在垃圾回收上。
真正的线索在第三张图表中:Order Service 的对外调用延迟(Outbound Call Latency),用 Histogram(直方图)度量——把响应时间划分到预设的时间桶中。这里 P50 依然保持在健康的 20ms,但 P99 却陡然升至 2.9 秒,而且从晚上 9 点起就一直在悄悄攀升。这证实 Order Service 完全健康,但在处理过程中它必须调用一系列其他服务,并且正被其中某个服务拖住。

但到这里,Metrics 的使命就结束了。用作者的话说,Metrics 本质上是聚合数字——它无法指着某个具体的请求,说它在调用哪个服务时变慢了。要再收紧一道篱笆,必须转向 Logs。
Logs 如何收紧包围圈?
系统中的日志行带有严重级别(INFO、WARN、ERROR),以 JSON 格式记录——即结构化日志(Structured Logging)——便于按字段过滤。Filebeat 这样的日志采集器监听每个服务的 stdout/stderr 流,并把日志推送到 Elasticsearch 建立索引。在 Grafana 中,直接对 Elasticsearch 数据源按 service = order-service、route = /checkout 和 duration >= 2000ms 过滤,所有被拖延的请求都会现形。打开一条耗时 2,970ms 的记录,可以看到拖慢它的正是发往 Inventory Service 的对外调用。
通常下一步是拿着 Trace ID——由 API 网关生成的唯一追踪标识,附在 HTTP Header 中,贯穿所有下游服务——去 Inventory Service 的日志中搜索。但一个非常真实的情况发生了:在 Inventory Service 的日志中搜索这个 Trace ID,结果空空如也,原因很简单:编写该服务的开发人员忘记配置把 Trace ID 写入日志上下文(例如 Java/SLF4J 中的 MDC——Mapped Diagnostic Context)。作者讲述这个细节,是一个务实的提醒:只有当 Trace ID 从网关层一直同步到数据库层时,日志系统才能发挥作用。
Traces 揭露了什么?
当日志断了线,最后一个揭露问题的工具是分布式追踪。用同一个 Trace ID 在追踪工具中查询,请求的整个生命周期会以时间线图表的形式呈现,由一个个 Span 组成——每个 Span 代表某个服务中的一个具体工作单元。查看这条耗时 3,120ms 的请求的时间线,画面变得极其清晰:请求经过 API 网关,被代理到 Order Service;Order Service 调用 Auth Service 验证用户,只花了 8ms;然后 Order Service 调用 Inventory Service,在那里被困了 2,970ms。
作者认为,追踪最有价值的部分在于展开 Inventory Service 内部的子 Span:SQL 查询本身实际上只花了 4ms,但紧挨着它的前一个 Span acquire connection(申请数据库连接)却耗费了 2,962ms。换句话说,数据库并不慢;慢的是等待分配一个连接来与数据库通信。
检查这个申请连接步骤的 Span Attributes(Span 属性)后,根本原因浮出水面:应用使用一个连接 PostgreSQL 的连接池,配置为 max_pool_size = 20。就在那一刻,全部 20 个连接都处于 in_use 状态(100% 被占用),还有 7 个其他请求在排队等待连接被释放。
连接池为什么会耗尽?
这就是经典的连接池耗尽(Connection Pool Exhaustion)故障,源于连接泄漏(Connection Leak)。在与数据库交互的代码中,某个处理流程从连接池借出一个连接,但在执行完毕——或抛出异常(Exception)时——忘记调用 close() 把连接还回连接池。每走一次这条有问题的代码分支,连接池就永久失去一个连接,直到触及 20 个连接的上限,后续请求只能等待,直到超时。这也解释了为什么 P99 从晚上 9 点起就一直在悄悄攀升:连接池是逐渐泄漏的,而不是突然崩溃的。
视频的结尾颇具幽默感,但也非常真实:由于这个 Inventory Service 是一位一年多前就已离职的人写的,而且没人敢在凌晨 3 点改代码,值班团队的临时处理办法(workaround)是重启 Pod/服务,把连接池清空重来。重启并不能修复缺陷——它只是重置了下一次连接池耗尽的倒计时。
立即应用:排查流程与彻底修复清单
分享帖中的缩小范围流程,可以直接用在你下一次值班处理故障时:
- 先仔细阅读告警,再打开仪表盘。 记下触发条件(例如:P99 > 2s 持续 5 分钟)、当前值与正常值的对比(3.2s 对比 180ms)、错误率和被点名的服务。一条好的告警已经包含了一半的诊断信息。
- 打开被点名服务的 Metrics,按顺序排除。 检查流量(Counter)以排除流量突增,检查 CPU/内存(Gauge)以排除资源耗尽,然后按百分位数查看对外调用延迟(Histogram):P50 健康而 P99 飙升,意味着服务本身没问题,只是在等待另一个服务。
- 带着精确的过滤条件转向 Logs。 按服务、路由和持续时间阈值过滤(例如:
duration >= 2000ms),打开一条缓慢的请求,看看哪次对外调用占用了大部分时间。 - 拿着 Trace ID 去查 Traces。 阅读 Span 时间线,展开最慢服务的子 Span,并阅读 Span Attributes——特别是与连接池、队列和等待时间相关的属性。
- 先止血,再治本。 用最安全的措施恢复服务(在这个故事中是重启),记录收集到的全部证据,然后在清醒且有代码评审的情况下再修改代码。
要彻底修复连接泄漏,作者给出了一份针对使用 HikariCP 的 Java/Spring Boot 团队的清单——其通用原则也适用于其他技术栈:
- 检查所有手动打开连接的地方,改用
try-with-resources块包裹,确保连接始终被关闭,即使抛出异常也不例外。 - 严格管理
@Transactional的生命周期,避免在不必要的长事务中一直持有连接。 - 开启
leakDetectionThreshold,让系统在某个连接被持有过久时自动打印堆栈跟踪(stack trace)告警。 - 确保 Trace ID 被写入每个服务的日志上下文,从网关层一直到数据库层,这样下一次 Logs 就不会断线。
三大支柱,各自回答不同的问题
| 支柱 | 它回答的问题 | 本次故障中的证据 | 作者眼中的局限 |
|---|---|---|---|
| Metrics(Prometheus/Grafana) | 系统是否过载?流量是否突增? | 流量平稳在每小时 40 个请求,CPU 为 4%,P50 为 20ms 但 P99 达 2.9 秒 | 只是聚合数字,无法指明哪个请求、哪个服务变慢了 |
| Logs(Filebeat/Elasticsearch) | 具体是哪个缓慢的请求?它卡在哪次调用上? | 一条 2,970ms 的记录显示,发往 Inventory Service 的调用是罪魁祸首 | 如果某个服务忘记把 Trace ID 写入日志上下文,Logs 就毫无用处——正如本故事中的 Inventory Service |
| Traces(分布式追踪) | 一个请求的时间都去哪了,精确到每一毫秒? | acquire connection Span 为 2,962ms,而 SQL 仅为 4ms;连接池 20/20 处于 in_use,7 个请求在等待 |
最详细,但也最费力——只有在 Metrics 和 Logs 缩小范围之后才使用 |
常见问题
1. P99 延迟是什么意思? P99 是响应时间的第 99 百分位数:99% 的请求都比这个值快,只有 1% 更慢。在本次故障中,P50 保持健康(20ms),但 P99 达到 2.9 秒——大多数请求仍然很快,但有一小部分请求被拖延了很久,而正是这一小部分造成了糟糕的体验和 504 错误。
2. 在 API 网关看到 504,是网关坏了吗? 按照作者的说法,不是。504 Gateway Timeout 意味着网关等待下游服务的响应等得太久。网关只是症状显现的地方;原因在它后面的某个服务里——在这个故事中是 Inventory Service。
3. 为什么重启服务能让故障暂时消失? 因为重启会清空连接池,并重新创建 20 个空闲连接。但泄漏的代码还在那里,所以连接池会再次逐渐耗尽,直到下一次枯竭。重启是临时处理办法,不是修复办法。
4. HikariCP 中的 leakDetectionThreshold 是做什么的?
它是连接泄漏检测阈值:当一个连接被持有超过该阈值仍未归还连接池时,HikariCP 会自动打印堆栈跟踪告警,让开发团队准确知道是哪段代码持有连接过久。
5. 如果系统还没有分布式追踪,该用什么排查? 仍然先从 Metrics 开始,排除过载和流量突增,然后用按服务、路由和持续时间过滤的 Logs 来查找缓慢的请求。但分享帖强调了一个先决条件:Trace ID 必须一致地附加到每个服务的日志中。缺少这一环,Logs 会在最需要它的时候断线——这就是为什么应该在故障发生之前、而不是之后投资建设追踪能力。
来源:Lữ Minh Khương 在 VGU Tech Alumni 小组中的帖子(2026/11/16),总结并评论了 YouTube 频道 pouria 的视频《3AM Observability Crash Course (A True Story)》。本文中的所有数字、服务名称和排查细节均来自视频中模拟的场景,由发帖作者复述——并非 Wotech 独立测量的数据。
Bài viết liên quan

18 tháng 11, 2026 · 2 phut doc
FPT Software 董事长:美国客户不再愿意按小时付费,公司转向按结果收费
人工智能正在迫使 FPT Software 转变其传统的软件外包模式:美国的大客户现在采用 100% 按结果付费的模式,公司预计 Time and Materials 模式的占比将在 2027 年降至约 50%。这是 FPT Software 董事长 Chu Thị Thanh Hà 在接受《日经新闻》采访时分享的内容——据 Hỏi Dân IT Official 页面的帖子(2026 年 11…

18 tháng 11, 2026 · 2 phut doc
Meta 将 Muse 扩展到澳大利亚:第六个国家、实时语音和本地应用集成
2026 年 11 月 17 日,Meta 将 Muse 扩展到澳大利亚市场——这是第六个获得官方支持的国家,距离其在美国上线仅两个多月。据 Hồ Hoàng Tiến 的帖子(2026 年 11 月 18 日)所说,值得注意的不仅是新增一个市场,而是 Meta 正在逐步将 Muse 从对话式 AI 工具发展为能够与应用交互、处理工作并执行所分配任务的助手。本文中的所有时间、功能和观点均来自该帖…

18 tháng 11, 2026 · 2 phut doc
AI 智能体成本随步骤数的平方增长:在换用更便宜的模型之前,先用 4 层方法削减 Token 开支
你不是在为答案付费——你是在为重复询问同一件事的次数付费。这是 Hoang Viet AI 在 comailo 小组帖子(2026 年 11 月 18 日)中的核心论点:一个运行 40 个步骤的智能体,在每一步都重新发送完整的对话历史,它不是在为 40 个答案付费,而是在为同一段上下文付费 40 次——而且这段上下文在每一步之后都会变长。该帖子也坦率地说明了它所依据的病毒式传播故事的局限性:作者…